L’IA va-t-elle remplacer le pentester ?
Sommaire
- 1. Une nouvelle étape pour le pentest
- 2. De l’enchaînement d’outils à l’investigation
- Le problème de la preuve
- Le problème du contexte
- 3. Ce que disent les recherches
- 4. Modèle du monde : prédire n’est pas comprendre
- 5. La mémoire d’investigation
- 6. TEGBESSOU : un copilote pour le pentester
- 7. Une architecture contrôlée par le pentester
- 8. Comment mesurer la valeur réelle de l’IA ?
- Conclusion : va-t-elle remplacer le pentester ?
- Sources
Ces derniers mois, je me suis beaucoup intéressé à l’IA appliquée au pentest. Les outils automatiques se multiplient, et une question revient sans cesse : peut-on confier un test entier à un agent, sans regard humain ? Pour y répondre, je suis parti des publications plutôt que des démonstrations commerciales, et j’ai vérifié chaque source citée. Ce texte présente ce que j’ai trouvé, y compris ce qui nuance mon propre projet.
1. Une nouvelle étape pour le pentest
L’automatisation n’est pas nouvelle. Depuis longtemps, les scanners et les scripts enchaînent la découverte de services, la recherche de vulnérabilités connues et la production de rapports. Ce qui change avec les modèles de langage, c’est la capacité à interpréter les résultats, à formuler une hypothèse et à décider de l’étape suivante.
Cette évolution devient concrète en 2026. Le 31 mars 2026, Amazon Web Services a rendu disponible AWS Security Agent pour des tests d’intrusion à la demande, qu’il présente comme un service de pentest autonome fonctionnant 24 h/24 [1]. La question n’est donc plus théorique : des organisations achètent déjà ce type de service.
Reste à savoir ce que ces systèmes font réellement, et ce qu’ils ne font pas.
2. De l’enchaînement d’outils à l’investigation
Un enchaînement classique (sous-domaines, services exposés, scanner de vulnérabilités) s’exécute sans difficulté. Ce qu’il ne sait pas faire, c’est décider quoi approfondir, relier deux observations ou abandonner une piste devenue inutile. C’est là qu’un agent peut apporter quelque chose : il lit les résultats, propose une vérification ciblée et ajuste son plan.
Mais proposer n’est pas savoir. Un modèle décide à partir de l’information qui lui est fournie. Si celle-ci est incomplète ou mal interprétée, il peut répéter un test déjà fait, suivre une fausse piste ou proposer une vérification qui ne répond pas à la question posée.
Une investigation fiable suit donc une boucle explicite :
- Observer : collecter les résultats et garder leur origine.
- Interpréter : séparer ce qui est observé de ce qui est supposé.
- Décider : choisir la suite selon les objectifs, les preuves et le périmètre autorisé.
- Exécuter : lancer uniquement les actions autorisées, à une cadence adaptée à leur risque.
- Évaluer : vérifier si le résultat confirme, affaiblit ou invalide l’hypothèse.
L’étape 5 est la plus souvent négligée. Un agent qui enchaîne les commandes peut paraître très actif sans avancer.
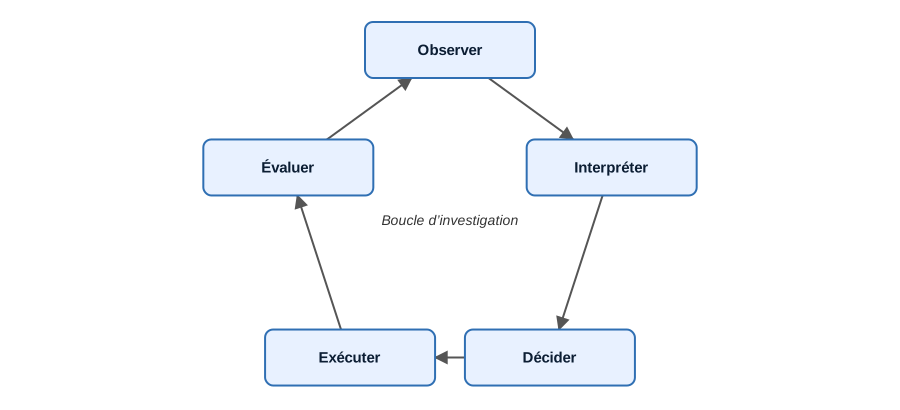
Figure 1 : la boucle d’investigation, de l’observation à l’évaluation.
Le problème de la preuve
Un scanner signale une injection SQL possible sur un paramètre d’URL. Ce signalement ne prouve pas la vulnérabilité : une réponse inhabituelle peut avoir plusieurs explications, et un résultat positif peut être faux.
Il faut donc distinguer trois niveaux : la détection d’un comportement suspect, l’investigation pour le comprendre, et la confirmation sur des preuves suffisantes. Si les éléments restent ambigus, la conclusion juste est « non confirmé », et non une réponse forcée.
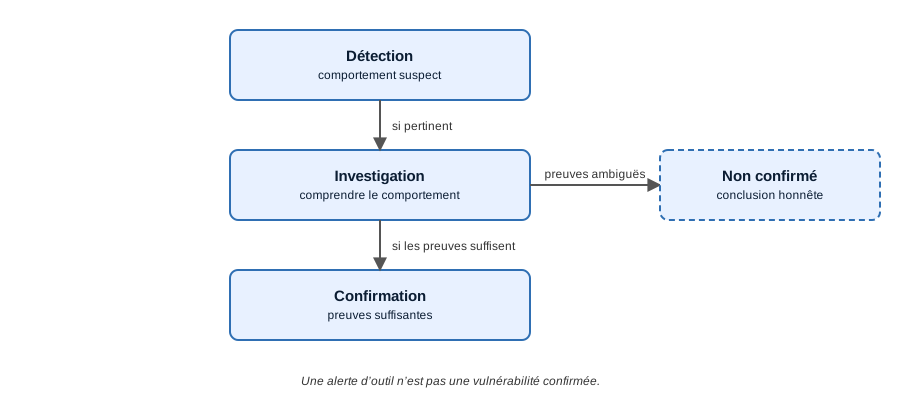
Figure 2 : de la détection à la confirmation, une alerte ambiguë reste non confirmée.
La priorisation obéit à la même exigence. Une vulnérabilité sévère n’est pas toujours la plus urgente : il faut tenir compte de l’exposition de l’actif, des conditions d’exploitation, des privilèges nécessaires et des conséquences pour l’organisation. Le score CVSS mesure la sévérité technique ; il ne remplace pas cette analyse.
Le problème du contexte
Une investigation s’étend sur plusieurs heures et plusieurs outils. Elle repose sur une suite de décisions : pourquoi une piste a été retenue, quels tests ont déjà été faits, quelles hypothèses ont été écartées. Un historique de conversation contient ces éléments, sans garantir qu’un agent les exploite correctement. Plus la conversation s’allonge, plus une information risque d’être omise ou confondue.
Il faut aussi empêcher qu’un agent transforme ses propres conclusions en faits établis. Une hypothèse répétée plusieurs fois ne devient pas une preuve.
À retenir : la valeur d’un agent de pentest tient moins à sa capacité à lancer des outils qu’à sa capacité à choisir les bonnes investigations et à justifier ses conclusions sans confondre hypothèse et preuve.
3. Ce que disent les recherches
Trois travaux récents éclairent ces questions. Ils viennent d’équipes différentes et portent sur des tâches différentes : leurs résultats ne se transposent pas automatiquement à tous les contextes.
Des résultats favorables, mais fragiles. Une étude présentée à l’ICLR 2026 compare dix professionnels et six agents existants, plus un agent conçu par les auteurs, ARTEMIS, sur un réseau universitaire réel d’environ 8 000 machines [2]. ARTEMIS se classe deuxième du classement général, et certaines de ses variantes coûtent 18 $ de l’heure, contre 60 $ pour un pentester professionnel. Les auteurs relèvent aussi des lacunes : un taux de faux positifs plus élevé, et un échantillon trop petit pour des conclusions statistiques solides.
Une conséquence mal anticipée. Une analyse préliminaire présentée à l’ICLR 2025 (« Web Agents with World Models ») affirme que des modèles comme GPT-4o ou Claude 3.5 Sonnet ne disposent pas d’un modèle du monde permettant de prévoir les effets de leurs actions [3]. Ces modèles datent de 2024, et la situation a pu évoluer. La question reste néanmoins ouverte pour les agents actuels.
Une activité qui masque une erreur. ATOBench étudie des agents de pentest face à des réponses trompeuses de la cible [4]. Les auteurs montrent qu’une activité accrue peut masquer une chaîne de vérification cassée, et que la réussite dépend de la capacité à trouver une preuve utilisable puis à la conserver jusqu’au rapport.
Ces travaux ne disent pas qu’un agent est inutile. Ils disent qu’un agent peut paraître performant tout en se trompant sur ce qui est réellement prouvé.
4. Modèle du monde : prédire n’est pas comprendre
La question centrale est la suivante : un modèle sait-il réellement ce que produira son action ?
Keyon Vafa et ses coauteurs ont entraîné des transformeurs sur des trajets de taxis new-yorkais [5]. Les modèles proposent presque toujours un virage valide, ce qui ressemble à une bonne compréhension de la ville. Pourtant, lorsque les chercheurs reconstruisent la carte qu’ils ont implicitement apprise, elle ressemble très peu au réseau réel, avec des rues aux orientations impossibles. Les auteurs concluent que ces modèles sont fragiles pour les tâches qui dépendent de cette structure : une bonne prédiction locale ne prouve pas une compréhension de la structure sous-jacente.
Un travail sur les agents à planification illustre le même écart [6]. Dans un cas étudié, le modèle ne voit pas qu’une action n’est pas exécutable, et prédit tout de même qu’elle réussira.
Pour le pentest, la conséquence est directe. Un agent peut annoncer qu’une faille est exploitable, qu’un service va tomber ou qu’un test est sans risque, sans avoir vérifié les conditions qui rendent cette affirmation vraie. La vérification doit donc venir de l’extérieur du modèle : une requête rejouée, une preuve conservée, une décision humaine. Une prédiction du modèle ne suffit pas.
5. La mémoire d’investigation
Un pentest produit beaucoup d’informations : actifs, résultats d’outils, hypothèses, tests effectués, décisions. Les garder sous forme de messages ne suffit pas à assurer une analyse cohérente. Trois mécanismes doivent être distingués :
- l’historique de conversation, qui conserve les échanges entre l’utilisateur et l’agent ;
- la mémoire structurée, qui conserve les actifs, observations, hypothèses, résultats et décisions de la mission ;
- le graphe de relations, qui conserve les liens entre ces éléments, avec leur provenance et leur niveau de confiance.
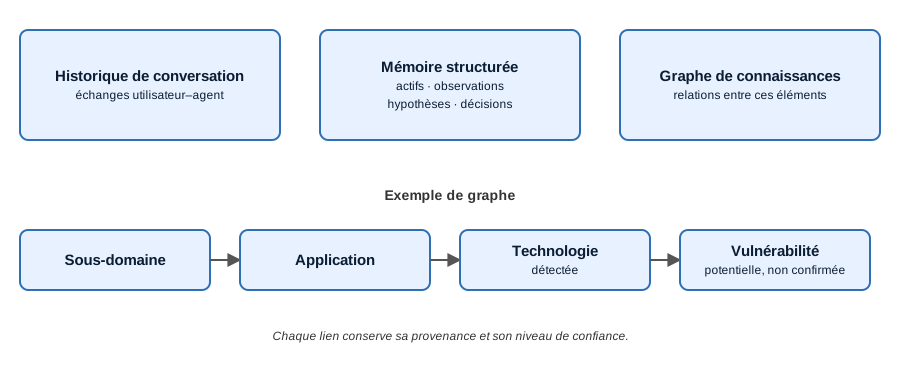
Figure 3 : historique, mémoire structurée et graphe de relations, avec un exemple de chaîne.
Un système de recherche documentaire (RAG) aide à retrouver une information ancienne, mais il ne représente pas à lui seul l’état d’une investigation ni les dépendances entre ses éléments. Une machine à états peut compléter l’ensemble : une piste est proposée, examinée, testée, puis confirmée ou rejetée. Elle évite de traiter une simple hypothèse comme un constat validé.
Le choix de la technologie doit suivre les besoins. Un graphe n’apporte pas de valeur parce qu’il est séduisant. La question centrale reste : que faut-il conserver pour qu’un agent puisse reprendre une investigation, comprendre les décisions précédentes et justifier sa prochaine action ?
6. TEGBESSOU : un copilote pour le pentester
TEGBESSOU est un projet personnel que je construis pas à pas. Cette section décrit ce qu’il doit devenir. Une grande partie reste à réaliser, et j’indique son état à la fin.
Le principe. TEGBESSOU est conçu comme un copilote, et non comme un agent autonome. Les agents doivent prendre en charge le travail lourd et répétitif (reconnaissance, scans, corrélation, rédaction de rapports), tandis que le pentester garde la stratégie, l’autorisation et les décisions. Un humain valide chaque phase. Le dépôt public affiche ce principe [7].
Ce qu’il doit faire :
- Définir le périmètre en premier. Les actifs, les limites et les opérations autorisées sont déclarés avant toute reconnaissance. Un agent ne doit pas élargir le périmètre de lui-même parce qu’il découvre un domaine ou un service associé.
- Centraliser les résultats. Des outils comme Nmap, Subfinder et httpx doivent alimenter une vue unique : sous-domaines, pages, technologies et points d’entrée, chaque observation étant reliée à sa source et à son horodatage.
- Cartographier les relations. Domaines, applications, technologies et vulnérabilités potentielles seraient reliés dans une carte, pour que le pentester voie ce qui a été observé, ce qui est seulement supposé et ce qui reste à vérifier.
- Proposer des investigations ciblées. Des agents spécialisés suggéreraient les pistes les plus pertinentes, en expliquant leur raisonnement et leurs incertitudes. Le pentester accepte, modifie ou refuse la proposition, et les investigations déjà menées seraient prises en compte pour éviter de répéter les mêmes tests.
- Séparer les preuves des affirmations. Un constat serait présenté comme observé, testé, confirmé ou incertain. Une alerte non confirmée ne serait jamais présentée comme une vulnérabilité avérée.
- Conserver une trace exploitable. Les commandes, leurs paramètres, les versions des outils, les résultats et les décisions seraient consignés, pour qu’une analyse puisse être reprise et qu’un rapport puisse être vérifié.
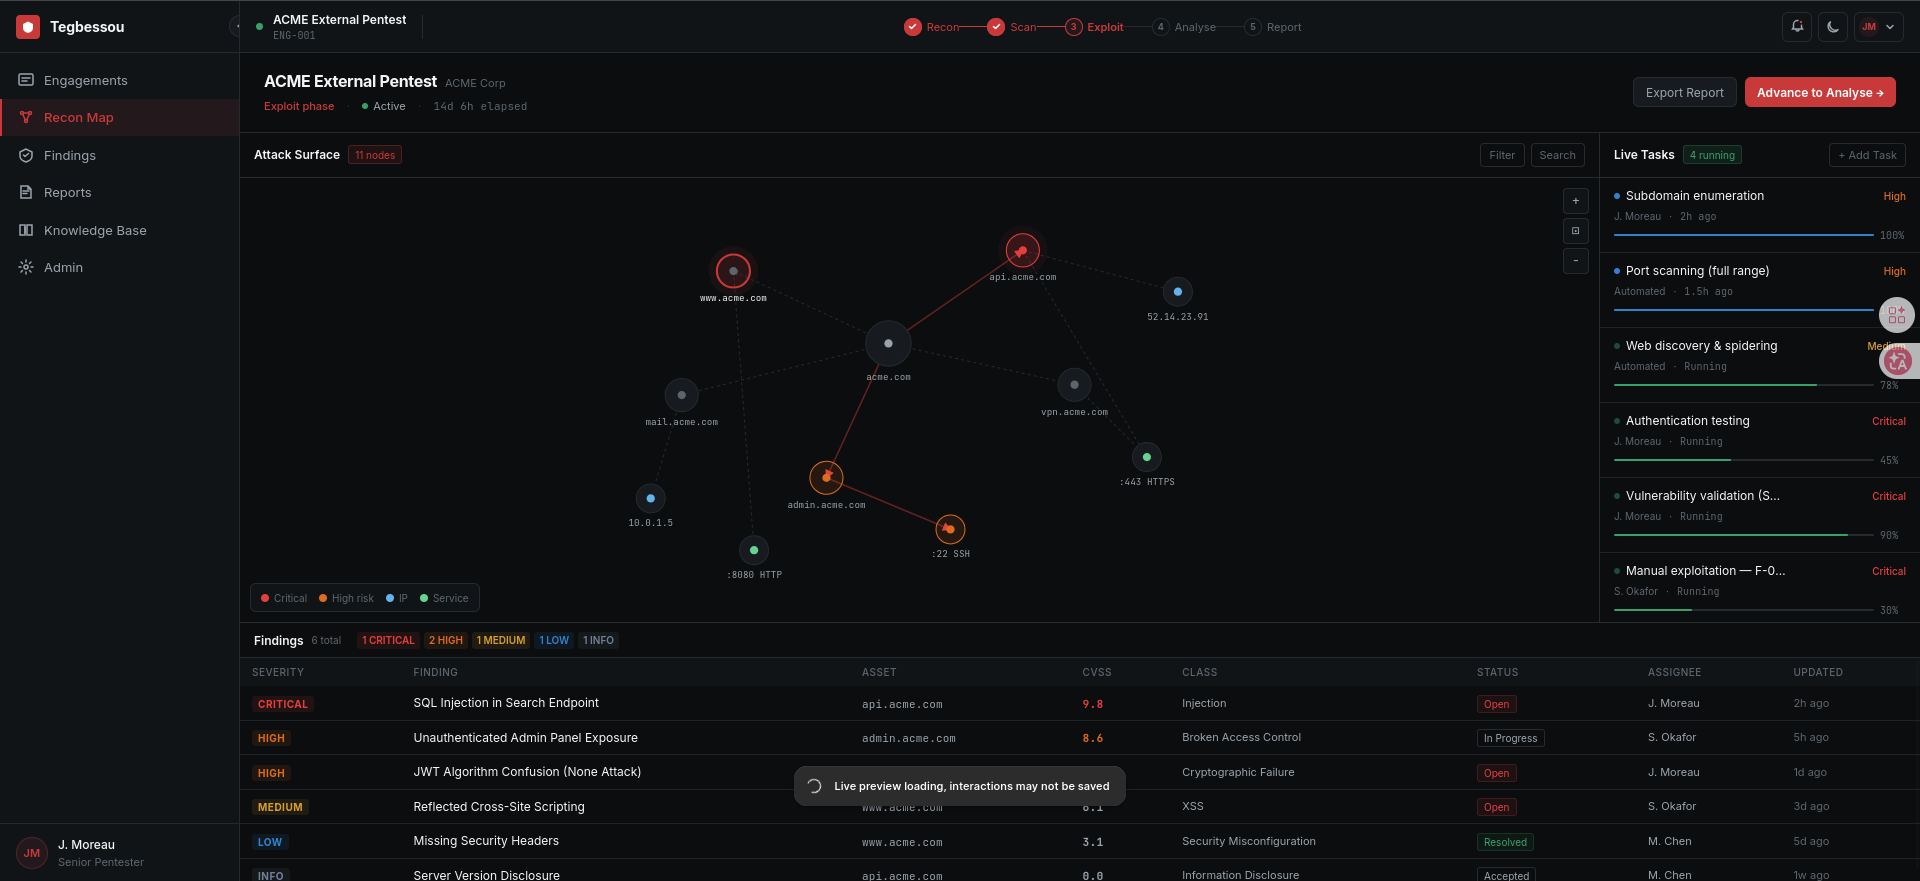
Capture du tableau de bord de TEGBESSOU, en cours de développement.
Les briques déjà présentes. Le dépôt contient déjà les éléments qu’un tel système demande : un orchestrateur, des passerelles réseau, un module de tests d’API, une interface en ligne de commande, un tableau de bord et un module d’ingestion de connaissances. Ce sont les fondations sur lesquelles les fonctionnalités ci-dessus doivent être construites.
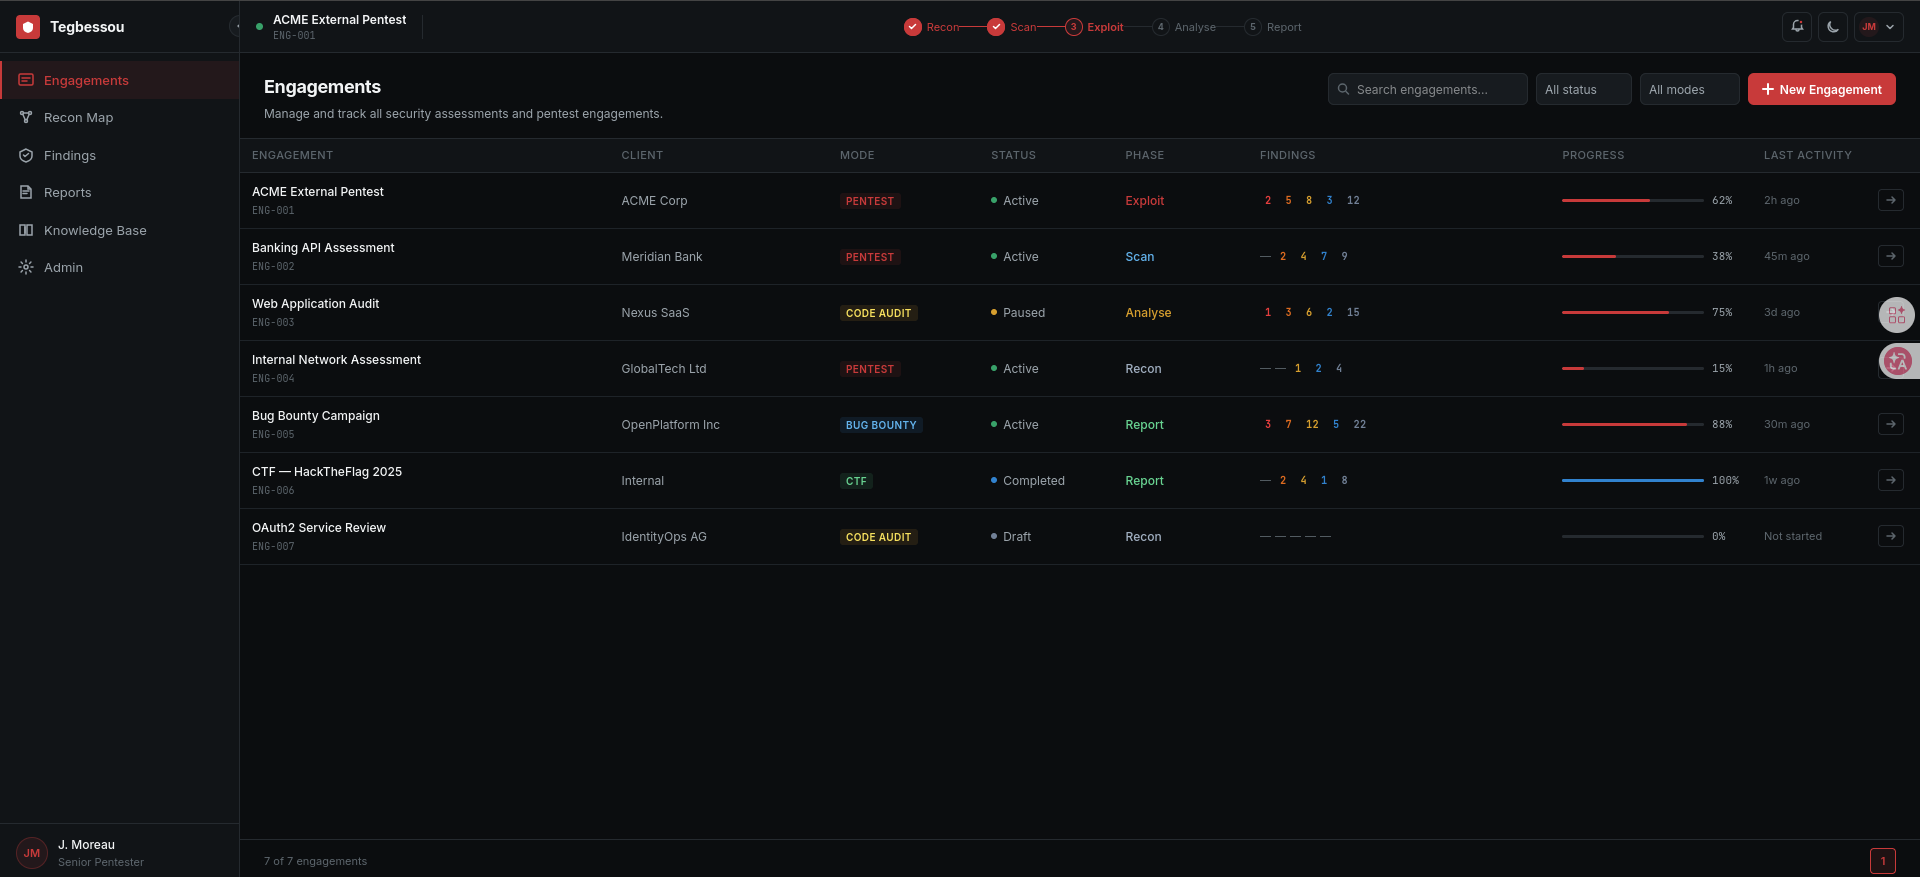
Capture du tableau de bord de TEGBESSOU, en cours de développement.
Où en est le projet. Le projet est en développement actif. Ses fondations (modèle de données, authentification, garde-fous) et sa mécanique d’engagement sont en place ; le reste est planifié et se construit étape par étape. Je n’ai pas encore de mesure publiée de ses résultats sur des cibles réelles, donc je ne fais aucune promesse de performance. Les mécanismes de mémoire et de vérification décrits plus haut sont des objectifs de conception, et non des fonctionnalités démontrées.
7. Une architecture contrôlée par le pentester
Les agents peuvent proposer des actions. Ils ne devraient pas pouvoir les exécuter sans contrôle. Prenons un cas simple : un agent lance un fuzzing trop intensif contre une application fragile. Une cadence excessive peut dégrader le service ou provoquer un déni de service ; une requête mal choisie peut modifier des données réelles.
Un système sérieux distingue donc les actions automatisables de celles qui exigent une validation humaine, et impose cette distinction au niveau du code. Pour TEGBESSOU, l’intention de conception est que le périmètre et l’autorisation soient vérifiés avant l’exécution, et non après.
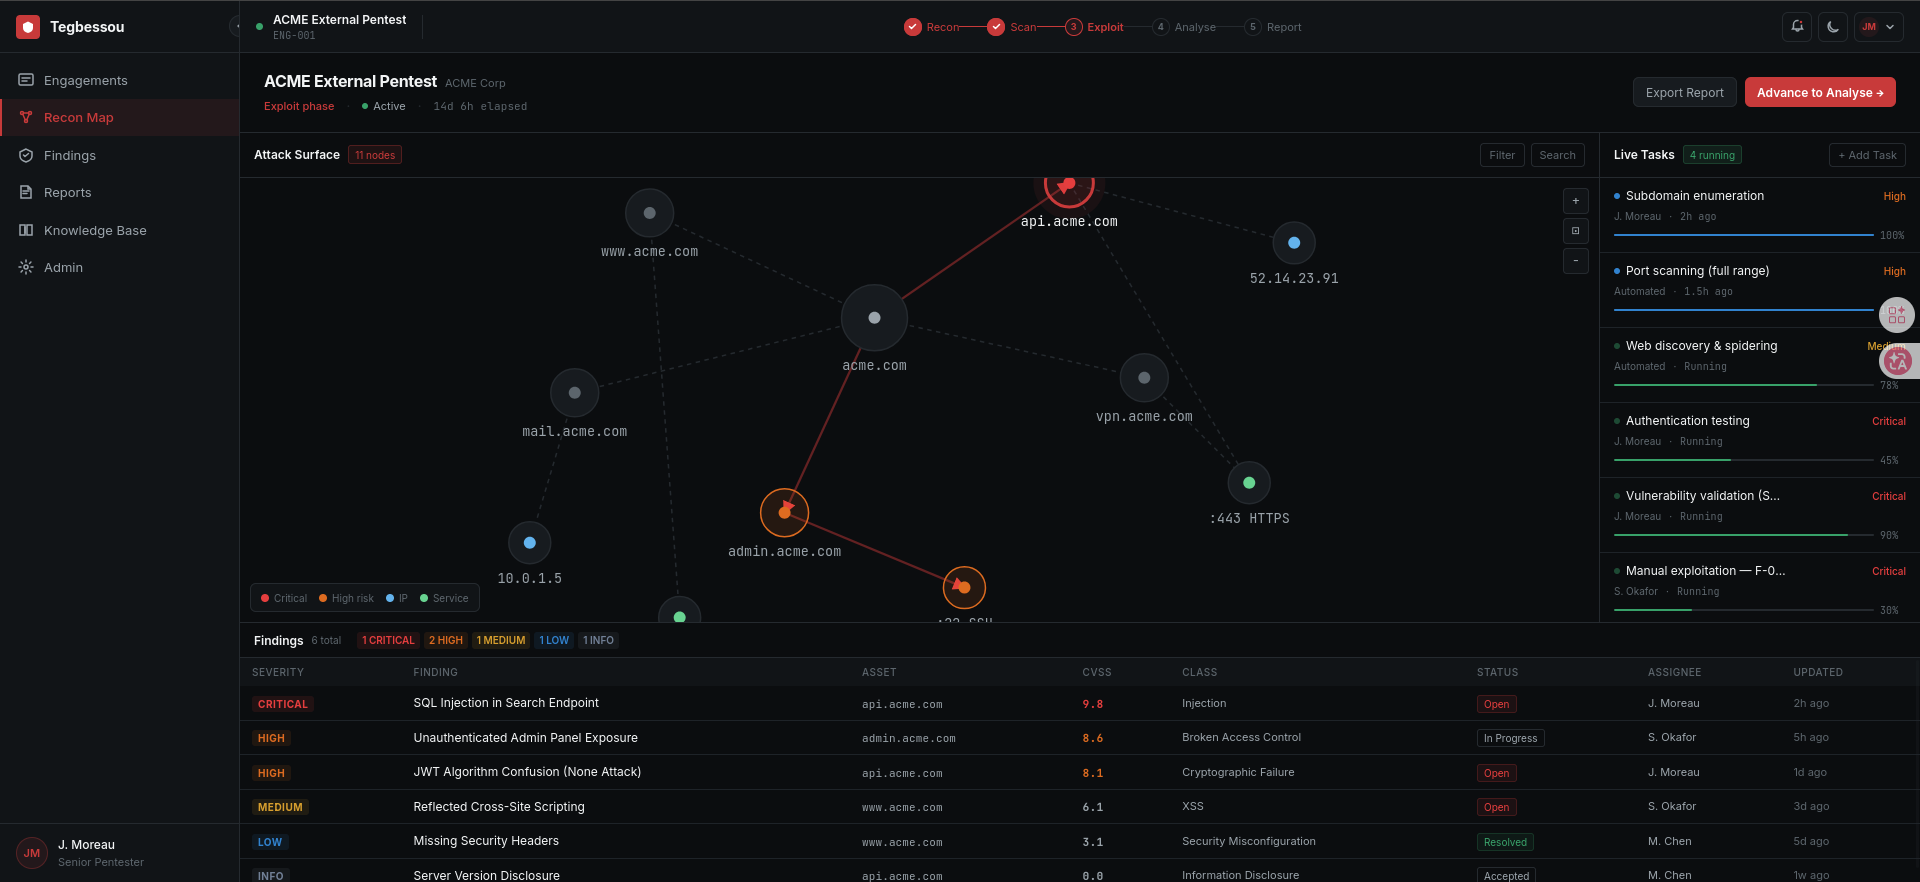
Capture du tableau de bord de TEGBESSOU, en cours de développement.
La reproductibilité compte aussi. Consulter un ancien résultat n’équivaut pas à relancer une commande : une nouvelle exécution peut modifier l’état de la cible. Le périmètre et les risques doivent donc être revérifiés avant chaque relance.
8. Comment mesurer la valeur réelle de l’IA ?
Le nombre de commandes exécutées ou de vulnérabilités signalées ne mesure pas la qualité d’un agent. Les indicateurs utiles sont plutôt :
- la part de vulnérabilités confirmées parmi celles qui sont signalées ;
- le nombre de faux positifs et d’investigations inutiles ;
- le temps nécessaire pour obtenir un constat vérifié ;
- la capacité à reproduire un résultat ;
- le respect du périmètre et des autorisations ;
- la qualité des preuves et des rapports.
L’étude de l’ICLR 2026 le montre : sans échantillon suffisant, on ne peut pas conclure. Avant de présenter le moindre résultat pour TEGBESSOU, il faudra un protocole d’évaluation sur des environnements contrôlés, appliquant ces indicateurs à un pentest classique comme référence.
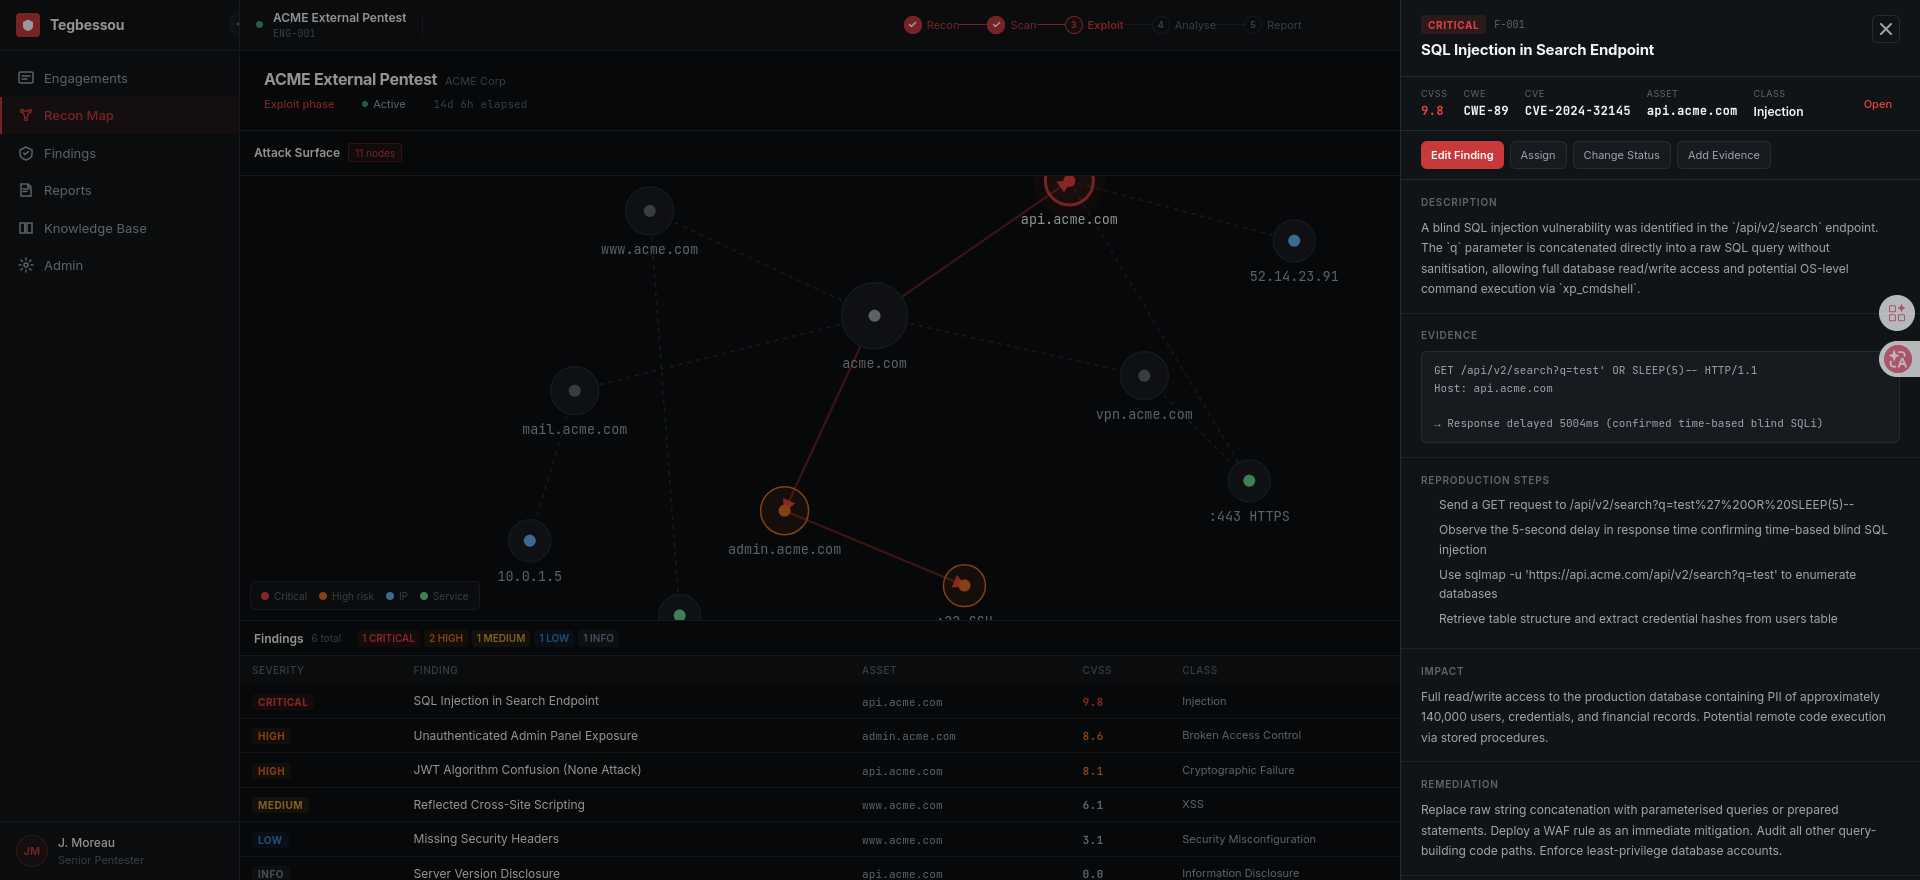
Capture du tableau de bord de TEGBESSOU, en cours de développement.
Conclusion : va-t-elle remplacer le pentester ?
Ma réponse : pas dans son ensemble, et probablement pas dans ce qui fait la valeur d’un test.
L’IA remplace déjà une partie du travail répétitif, et elle accélère l’énumération et la corrélation. Elle change aussi le métier, qui se déplace vers la validation, le tri et la rédaction. Mais ce qui engage la responsabilité reste humain : définir le périmètre et l’autorisation, juger de la pertinence d’une piste, répondre des conclusions, et repérer ce que le modèle ne voit pas, notamment les conséquences de ses propres actions.
Je ne peux pas encore dire si TEGBESSOU tiendra cette ligne en pratique. Je sais seulement pourquoi je la trace : la confiance dans un test ne vient pas de la vitesse de l’outil, mais de la capacité à montrer comment une conclusion a été obtenue.
Et vous, quelle tâche du pentest laisseriez-vous aujourd’hui à une IA ?
Sources
[1] AWS, « AWS Security Agent on-demand penetration testing is now generally available », 31 mars 2026 : https://aws.amazon.com/about-aws/whats-new/2026/03/aws-security-agent-ondemand-penetration
[2] Justin W. Lin et al., « Comparing AI Agents to Cybersecurity Professionals in Real-World Penetration Testing », ICLR 2026, arXiv:2512.09882 : https://arxiv.org/abs/2512.09882
[3] « Web Agents with World Models », ICLR 2025 : https://proceedings.iclr.cc/paper_files/paper/2025/file/a00548031e4647b13042c97c922fadf1-Paper-Conference.pdf
[4] Qiyang Chen et al., « ATOBench: Tracing How Autonomous Penetration-Testing Agents Verify Vulnerabilities When Target Evidence Lies », arXiv:2608.12996, août 2026 : https://arxiv.org/abs/2608.12996
[5] Keyon Vafa et al., « Evaluating the World Model Implicit in a Generative Model », NeurIPS 2024, arXiv:2406.03689 : https://arxiv.org/abs/2406.03689
[6] « Self-Evolving World Models for LLM Agent Planning », arXiv:2606.30639 : https://arxiv.org/abs/2606.30639
[7] Dépôt TEGBESSOU : https://github.com/K1NG5P4RR0W/TEGBESSOU